-
UUIDv7을 쓰면 ID에서 생성 시간이 드러날까Programming 2026. 10. 11. 00:05728x90반응형
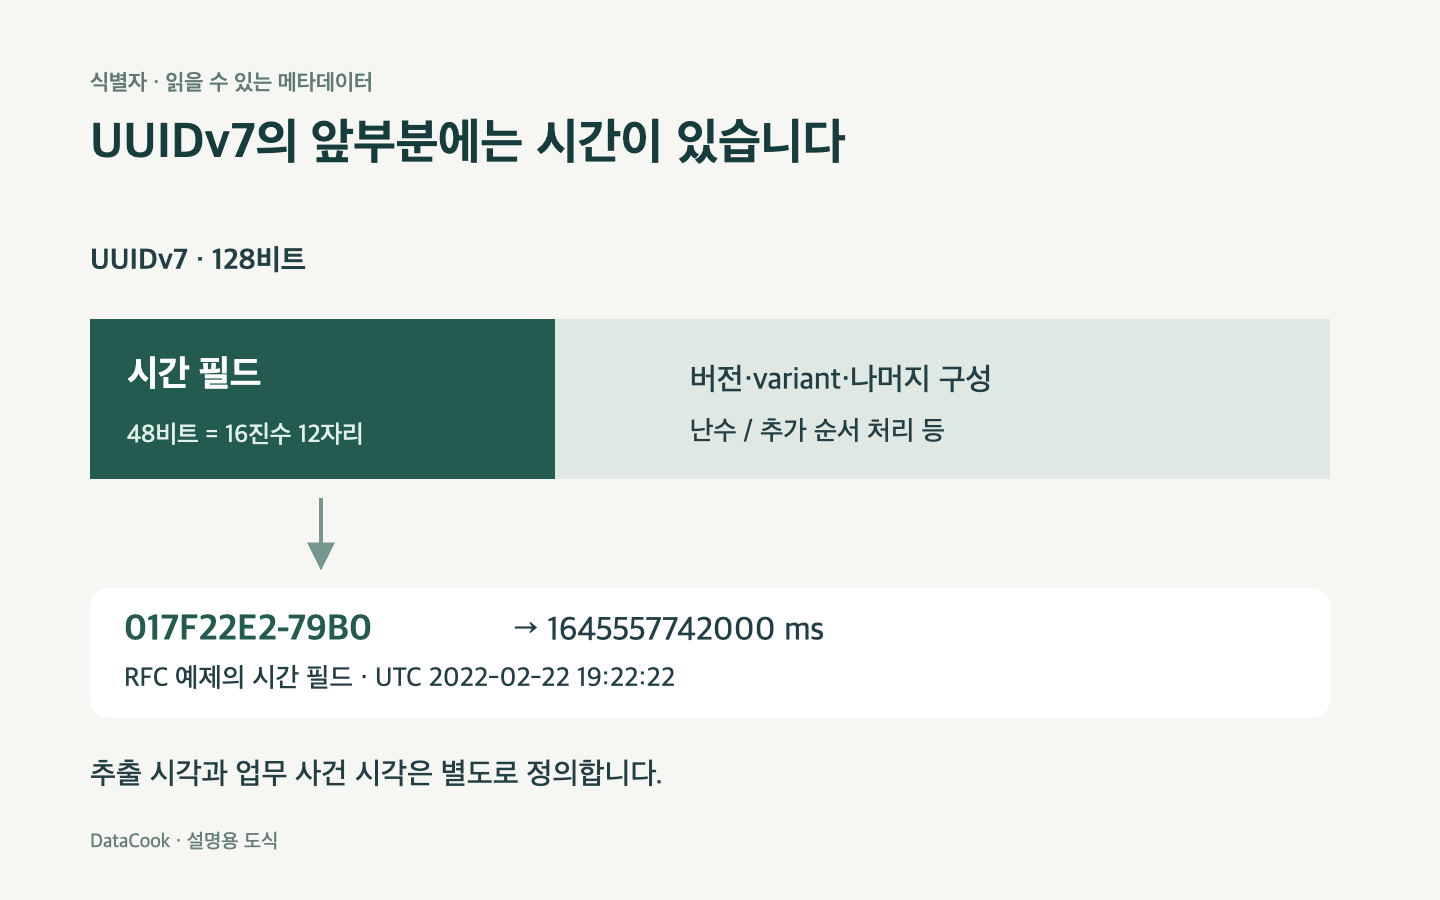
시간 필드만 비율에 맞춰 구분했으며 뒤쪽의 세부 비트 배치는 생략했습니다. UUIDv7을 공개 식별자로 쓰면 ID에 담긴 시간 필드를 읽을 수 있습니다. 앞부분에 Unix epoch 기준 밀리초 값이 들어 있기 때문입니다. UUIDv7을 공개 식별자로 쓰기 전에 시간 정보가 드러나도 되는지와 그 시간을 업무 시각으로 사용해도 되는지를 나눠 판단하세요.
URL에 붙은 문자열이 길고 무작위처럼 보여도 시간 부분까지 감춰지는 것은 아닙니다. 다만 그 값을 읽었다고 게시물이 작성된 순간이나 서버가 저장한 순간을 정확히 알아낸 것은 아닙니다. ID를 만든 쪽이 어떤 시계를 썼는지, 생성과 저장 사이에 어떤 일이 있었는지가 남습니다.
이 글은 2026년 9월 28일 확인한 RFC 9562와 PostgreSQL 18 문서를 바탕으로 합니다. 공개된 표준 예시를 풀어 읽으며 실제 서비스의 ID를 조사하거나 성능을 측정하지 않았습니다.
앞 12개의 16진수가 시간 필드입니다
UUID는 128비트 식별자입니다. UUIDv7은 맨 앞 48비트에 Unix 밀리초 시간을 배치합니다. 16진수 한 자리가 4비트이므로 48비트는 12자리입니다. 문자열의 하이픈을 제외하고 앞 12자리를 읽으면 이 시간 필드에 해당합니다. UUIDv7 구조
RFC에 실린 예시를 사용하면 위치가 더 분명합니다.
시간: 017F22E2-79B0
나머지: 7CC3-98C4-DC0C0C07398F
여기서
017F22E279B0은 16진수이고, 10진수로 읽으면1645557742000입니다. 밀리초를 초로 바꾸면1645557742초이며 UTC로 2022년 2월 22일 19시 22분 22초에 해당합니다. 이는 RFC의 예제 값에 대한 해석입니다. RFC의 UUIDv7 예제아래 Python 코드는 같은 변환을 표현합니다. 입력은 위 표준 예시처럼 UUIDv7임을 알고 있는 값으로 한정했습니다. 일반 입력 검증 함수로 쓰려면 UUID 형식과 버전 검사도 필요합니다.
from datetime import (
    datetime, timezone
)

sample = (
    "017F22E2-79B0-"
    "7CC3-98C4-DC0C0C07398F"
)
compact = sample.replace("-", "")
unix_ms = int(compact[:12], 16)
encoded_time = (
  datetime.fromtimestamp(
    unix_ms / 1000,
    tz=timezone.utc
  )
)
누군가에게 공개 ID를 전달했다면 그 사람은 별도의 비밀키 없이 이 필드를 읽을 수 있습니다. 식별자가 URL에만 있거나 API 응답에만 있어도 이 성질은 같습니다.
나머지 부분에는 버전·variant 비트와 난수 또는 추가 순서 처리를 위한 값이 들어갑니다. 시간 부분 뒤가 전부 순수 난수라고 가정해 직접 생성기를 만드는 것은 피해야 합니다. RFC가 허용하는 세부 구성과 같은 밀리초 안의 처리 방식은 구현에 따라 달라질 수 있습니다.
ID에 담긴 시각과 서버에 저장한 시각을 구별합니다
휴대폰 메모 앱의 가상 사례를 보겠습니다. 기기가 09:00에 메모를 작성하면서 UUIDv7을 만들고, 네트워크가 끊겨 있다가 11:30에 서버에 올렸다고 가정합니다.
이 경우 앱에서 필요할 수 있는 시각은 서로 다릅니다. 사용자가 메모를 작성한 시각은 09:00입니다. 서버가 받아 저장한 시각은 11:30이고, UUID 시간 필드는 기기의 생성기가 넣은 값입니다. 기기의 시계가 틀렸다면 이 값은 실제 09:00과도 어긋날 수 있습니다.
서버에서
uuid_extract_timestamp(id)만 읽어created_at으로 쓰면 서버 수신 시각을 잃습니다. 반대로 서버의created_at을 작성 시각으로 표시하면 오프라인 대기 시간이 사용자 행동에 섞입니다. UI에 어느 시각을 보여 줄지에 따라 별도 필드가 필요합니다.occurred_at: 어떤 사용자 사건의 시각인지 정의하고 입력 출처를 기록합니다.received_at: 서버가 수신한 시각을 기록합니다.- ID의 시간 필드: 생성기가 넣은 값을 필요할 때 추출합니다.
이름 자체가 정확성을 보장하지는 않습니다. 클라이언트가 제공한 시간을 신뢰할지, 서버가 어느 처리 지점에서 수신 시간을 기록할지까지 정해야 합니다. 위 구분은 오프라인 전송 사례의 설계 판단이며 UUID 표준이 세 필드를 의무화한다는 뜻은 아닙니다.
PostgreSQL 18에서는 버전과 시간을 따로 읽습니다
PostgreSQL 18의
uuid자료형에는 여러 버전의 UUID를 담을 수 있습니다. 컬럼이uuid라는 이유만으로 모든 행이 v7인 것은 아닙니다. 기존 v4와 새 v7이 섞인 테이블을 검사한다면 다음처럼 버전도 함께 읽습니다.SELECT id, uuid_extract_version(id) AS version, uuid_extract_timestamp(id) AS encoded_time FROM sample_notes;sample_notes는 설명용 테이블 이름입니다.uuid_extract_timestamp는 v1과 v7에서 시각을 추출하며 다른 버전에는 NULL을 반환합니다. v4 행의 NULL을 현재 시각으로 채워 버리면 추출하지 못한 자료를 방금 만들어진 자료처럼 바꾸게 됩니다. PostgreSQL UUID 함수같은 문서는 추출한 시각이 실제 UUID 생성 순간과 정확히 같지 않을 수 있다고도 설명합니다.
uuidv7()에는 시간값을 이동시키는shift인자도 있습니다. 예를 들어uuidv7(interval '1 day')로 만든 값의 시간을 사건 발생 시각으로 사용하면 의미가 달라집니다.따라서 기존
created_at을 없애기 전에 그 컬럼이 무슨 시각을 기록했는지부터 확인해야 합니다. ID에서 시간이 나온다는 이유만으로 컬럼이 중복된다고 결론 낼 수는 없습니다.정렬에 쓸 때도 생성 주체를 봅니다
UUIDv7의 시간 배치는 시간 순서 정렬에 활용할 수 있게 설계됐습니다. 그렇지만 서로 다른 기기에서 생성한 ID를 정렬한 결과가 사건의 엄밀한 인과 순서를 뜻하지는 않습니다. 기기 시계가 어긋나거나 같은 밀리초에 여러 값이 만들어질 수 있기 때문입니다.
예를 들어 서버 A가 처리한 요청 뒤에 서버 B가 후속 작업을 했어도, 두 시계가 어긋나 있으면 ID의 시간만으로 그 관계를 복원하기 어렵습니다. 순서가 업무 규칙을 결정한다면 별도 순번이나 사건 간 참조처럼 필요한 기준을 명시해야 합니다. 시계와 단조 증가에 관한 고려
저장 성능을 이유로 v7을 고를 때도 대상 DB와 작업에서 비교해야 합니다. 이 글의 시간 필드 설명은 특정 인덱스나 쿼리가 얼마나 빨라진다는 측정 근거가 아닙니다.
공개 ID를 고르는 기준
등록 시점과 관련된 단서가 외부에 드러나도 괜찮다면 UUIDv7을 후보로 검토할 수 있습니다. 그 단서를 노출하고 싶지 않다면 시간 필드가 없는 UUIDv4나 별도의 공개 식별자 설계를 검토합니다. 이미 공개한 ID의 형식을 바꾸는 작업은 링크와 참조의 호환성도 고려해야 합니다.
어느 쪽이든 요청자가 해당 객체를 볼 권한이 있는지는 서버가 검사해야 합니다. RFC는 UUID를 소유한 것만으로 접근을 허용하는 보안 수단으로 쓰지 말라고 안내합니다. UUID 보안 고려 사항
실무에서는 공개 여부를 결정하기 전에 사용하는 생성기와 버전, 생성 위치, 별도로 기록하는 업무 시각을 적어 두면 됩니다. 그 목록에서 공개 ID의 시간 노출을 허용할 수 있는지 판단하고, 화면의 날짜와 정렬이 어느 값을 사용하는지 확인하세요.
728x90반응형'Programming' 카테고리의 다른 글
Python Workers의 Python 버전은 누가 정할까 (0) 2026.10.13 같은 글의 주소가 여러 개일 때: canonical과 301 중 무엇을 쓸까 (0) 2026.10.11 블로그 제목을 바꿨는데 Google에는 다른 제목이 뜨는 이유 (0) 2026.10.11 아이폰 사진이 HEIC라서 안 열릴 때, 촬영 설정부터 바꿔야 할까 (0) 2026.10.11 Syncthing으로 지운 파일도 같이 지워졌다면: 버전 관리 켜는 기준 (0) 2026.10.08