-
CSV 한글이 Excel에서만 깨질 때: UTF-8과 가져오기 경로Data Analysis 2026. 10. 6. 00:28728x90반응형
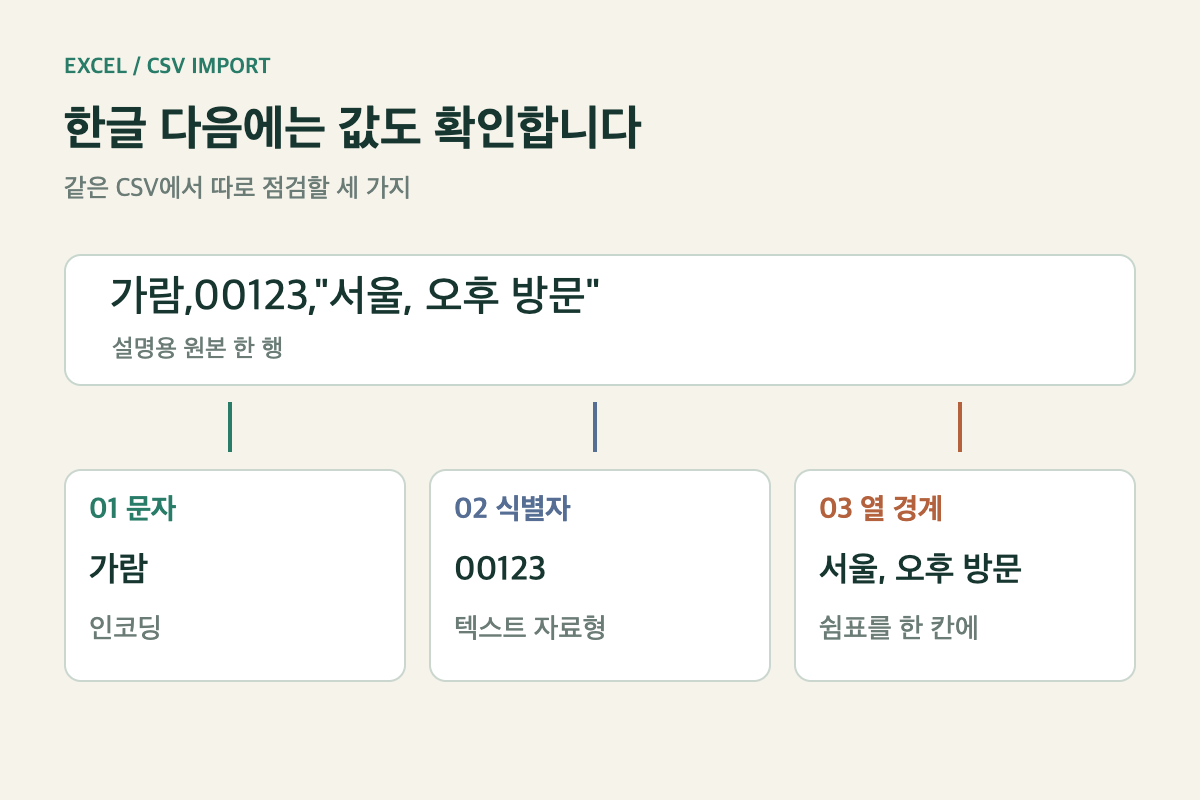
인코딩·자료형·열 구분은 따로 확인합니다. 값은 설명용이며 실제 Excel 화면이 아닙니다. 편집기에서는 ‘가람’으로 보이는 이름이 Excel에서만 낯선 문자로 나타납니다. 파일을 두 번 눌러 열 때 Excel이 문자 인코딩을 다르게 읽었을 수 있습니다. 원본 인코딩을 확인한 뒤 Excel의 Text/CSV 가져오기 경로를 사용하고, 깨진 화면을 다시 저장해 원본을 덮어쓰지 마세요.
파일을 두 번 눌러 여는 것과 인코딩을 골라 가져오는 것은 출발점이 다릅니다. 가져오기 미리보기에서는 문자가 어떻게 읽히는지 확인한 다음 시트로 넣을 수 있습니다. 아래는 Microsoft 문서를 2026년 9월 28일 확인해 정리한 절차입니다. 실제 Excel 화면이나 사용자 파일을 조작한 기록은 아니며 메뉴 위치는 설치한 Excel의 버전과 운영체제에 따라 다릅니다.
같은 파일에서 세 가지를 따로 봅니다
다음은 설명용 CSV입니다. 개인 정보가 아닌 가상 값이며 첫 메모에는 쉼표가 들어 있습니다.
이름,회원코드,메모
가람,00123,"서울, 오후 방문"
나래,00456,자료 확인
이 파일을 받으면 처음부터 기대 결과를 정할 수 있습니다. 이름은 ‘가람’과 ‘나래’, 회원코드는 다섯 자리, 메모는 쉼표를 포함한 한 칸이어야 합니다. 이 세 항목이 각각 인코딩, 자료형, 열 구분을 확인하는 표본이 됩니다.
한글이 깨졌다면 바이트를 문자로 읽는 방식을 봅니다. 모든 내용이 한 열에 몰렸다면 구분자를 봅니다. 회원코드가
123으로 줄었다면 숫자 변환을 봅니다. 한글이 정상이라는 이유로 뒤의 두 문제를 놓치기 쉽습니다.CSV 확장자는 이런 조건을 모두 담고 있지 않습니다. 내보낸 시스템의 인코딩 설정을 확인하거나 파일 제공자에게 물어보세요. 화면이 깨졌다는 이유만으로 UTF-8, CP949 등을 차례로 적용하고 그때마다 저장하면 어느 단계에서 값이 바뀌었는지 찾기 어려워집니다.
BOM 없이 받은 UTF-8 파일은 가져오기에서 엽니다
Microsoft는 UTF-8 CSV가 BOM과 함께 저장됐다면 일반적인 열기로 읽을 수 있다고 안내합니다. BOM은 파일 앞에 놓이는 식별 단서입니다. BOM이 없는 UTF-8 CSV에는 Power Query의 Text/CSV 가져오기 등을 안내합니다. Excel에서 UTF-8 CSV 열기
중요한 조건은 파일 내용 자체가 UTF-8이어야 한다는 점입니다. 다른 인코딩의 바이트 앞에 표시만 붙인다고 UTF-8로 변환되는 것은 아닙니다. 파일을 만드는 쪽에서는 실제 인코딩과 수신자가 사용할 열기 방식을 함께 정해야 합니다.
Excel의 데이터 탭에서 텍스트/CSV 가져오기를 찾아 원본 파일을 선택하세요. Microsoft가 설명하는 메뉴는 데이터 가져오기 → 파일에서 → 텍스트/CSV입니다. 해당 메뉴가 없다면 설치된 환경의 텍스트 가져오기 기능을 확인합니다. 기능이 없는데 파일 확장자만 바꾸는 것으로 해결하려 하지는 마세요.
미리보기에서는 파일 원본의 문자 집합을 UTF-8로 선택하고 이름을 읽어 봅니다. 이 선택은 파일이 UTF-8이라고 확인한 경우의 절차입니다. 그래도 이름이 틀리면 파일의 생성 설정이나 변환 전 사본으로 돌아갑니다. 이미 원래 글자가 다른 문자로 대체돼 저장됐다면 가져오기 설정만으로 원문을 결정할 수 없습니다.
회원코드를 숫자로 바꾸기 전에 멈춥니다
Power Query의 Text/CSV 연결기는 문자 집합뿐 아니라 구분자와 자료형 감지도 선택하게 합니다. 자동 자료형 감지를 끄면 열을 Text로 읽을 수 있습니다. Text/CSV 연결기 옵션
예제에서는 쉼표 구분을 선택한 뒤 이름·회원코드·메모가 세 열로 보이는지 확인합니다.
"서울, 오후 방문"은 따옴표 안에 쉼표가 있으므로 한 메모로 남아야 합니다. 메모가 두 칸으로 갈라졌다면 인코딩을 다시 고르기보다 따옴표와 구분자 처리를 확인할 차례입니다.그다음 회원코드 열을 텍스트로 유지합니다. 가져오기 과정에 자동으로 ‘변경된 유형’ 단계가 추가됐다면 그 단계에서 이미 숫자로 바꾸지 않았는지도 보세요. 한 번
123이 된 값을 나중에 텍스트로 지정하면 보통 문자123을 얻을 뿐, 사라진 두 자리 0을 파일에서 다시 읽는 것은 아닙니다.원래 코드 길이를 알고 있으면 표시 서식으로 0을 채울 수도 있지만, 지금 필요한 것은 원본의 식별자를 보존하는 일입니다. 원문을 다시 가져오면서 변환 전에 텍스트로 두는 편이 목적에 맞습니다. 금액·수량처럼 계산할 열은 이후 그 열의 의미에 맞게 숫자로 변환할 수 있습니다.
저장한 사본도 다시 읽습니다
예제의 통과 조건은 구체적입니다. 두 이름이 읽히고
00123·00456이 유지돼야 합니다. 첫 메모의 쉼표가 한 칸 안에 남고, 행이 예상치 않게 늘거나 줄지 않아야 합니다. 몇 줄의 미리보기가 전체 파일을 대표하지는 않으므로 실제 자료에서는 중요한 열의 누락·중복과 전체 행 수도 따로 대조합니다.작업 결과는 원본과 다른 이름으로 저장하세요. Excel 작업을 계속할 파일인지, 다른 시스템에 다시 넘길 CSV인지에 따라 저장 형식도 달라집니다. CSV로 내보낼 경우 받는 프로그램이 요구하는 인코딩·구분자를 확인하고, 저장한 파일을 그 경로로 다시 읽어 봅니다. Excel에서 한 번 보였던 값이 최종 전달 파일에도 남아 있는지가 마지막 확인입니다.
다음번에 같은 파일을 받아도 헤매지 않으려면 원본 인코딩, 가져오기 경로, 텍스트로 유지할 열을 함께 적어 두세요. 이번 예제라면 ‘UTF-8, Text/CSV 가져오기, 회원코드 Text’까지가 재사용할 설정입니다.
728x90반응형'Data Analysis' 카테고리의 다른 글
CSV를 열었는데 수식이 실행된다면: 따옴표만으로 부족한 이유 (0) 2026.10.06 API의 긴 숫자 ID가 JavaScript에서 바뀌는 이유 (0) 2026.10.06 JSON에 같은 키가 두 번 있으면 어느 값이 남을까 (0) 2026.10.06 제외 목록에 NULL 하나 넣었더니 SQL 결과가 사라지는 이유 (1) 2026.10.05 UNIQUE를 걸었는데 빈 값이 여러 개 들어가는 이유 (0) 2026.10.05