-
model.eval()과 inference_mode()는 왜 둘 다 필요할까AI Agent 2026. 9. 28. 21:25728x90반응형
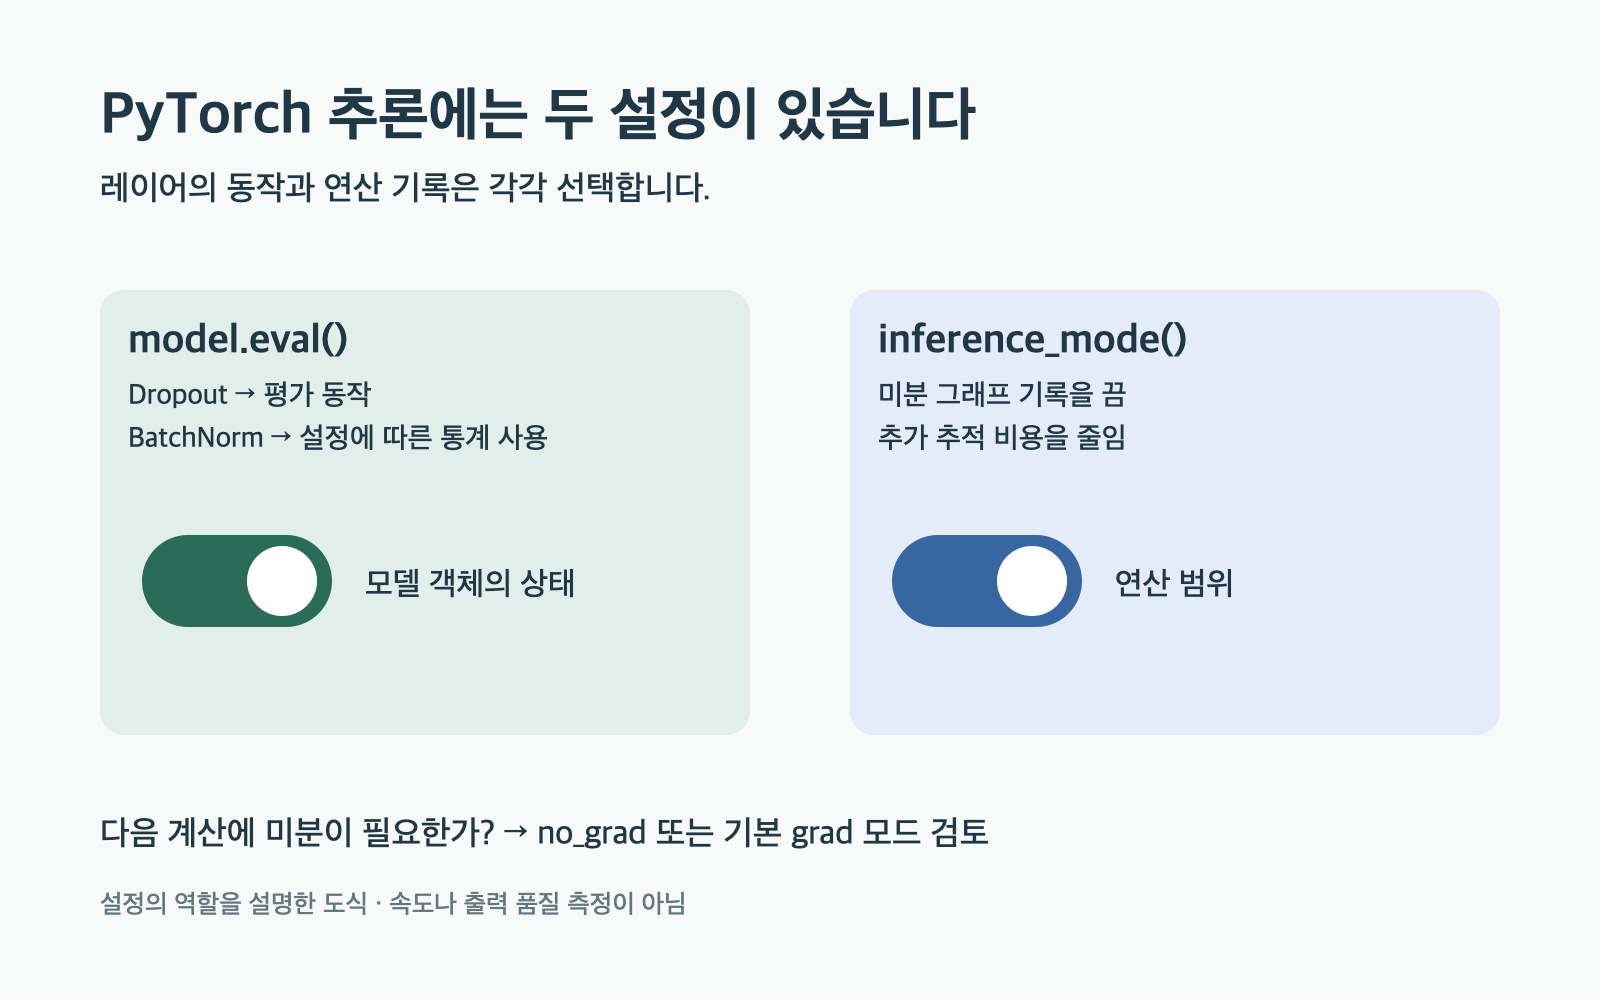
eval은 모델의 평가 동작을, inference_mode는 연산 기록을 조정합니다. 추론 함수에
model.eval()을 넣었는데도 출력에grad_fn이 붙어 있습니다. 반대로inference_mode()로 감쌌는데 Dropout은 여전히 값을 무작위로 지웁니다. 두 상황 모두 설정 하나가 빠졌을 때 나올 수 있습니다. eval은 레이어의 동작을, inference_mode는 자동 미분의 기록 방식을 바꿉니다.모듈의 학습·평가 동작과 gradient 기록을 별도로 설정하고, 사용하는 레이어의 동작을 확인하세요. 보통의 예측 서비스에서는 두 설정을 함께 쓰지만, 입력에 대한 미분을 구하거나 추출한 특징으로 다른 모델을 학습할 때는 선택이 달라집니다.
아래 설명은 2026년 9월 28일 확인한 PyTorch 2.14 문서 기준입니다. 코드는 모드를 구분하기 위한 미학습 모델 예제이며, 예측 정확도나 실행 속도를 측정한 결과는 아닙니다.
eval만 호출한 모델에서 기록이 남는 이유
PyTorch는 연산을 수행하면서 나중에 미분할 때 필요한 관계를 기록할 수 있습니다. 이 기능이 autograd입니다. 반면
eval()은 모델과 하위 모듈을 평가 상태로 바꿉니다. 자동 미분을 끄는 함수가 아니므로, 학습 가능한 가중치로 계산한 결과에는 평가 상태에서도 미분 기록이 생길 수 있습니다. PyTorch의 평가 모드 설명작은 모델로 확인할 지점을 나눠보겠습니다. 바깥쪽에서 다른 grad 모드를 적용하지 않은 기본 실행 상태를 가정합니다.
import torch

model = torch.nn.Sequential(
    torch.nn.Linear(4, 4),
    torch.nn.Dropout(p=0.5),
)
x = torch.ones(2, 4)

model.eval()
y_eval = model(x)

with torch.inference_mode():
    y_infer = model(x)

print(model.training)
print(
    y_eval.requires_grad,
    y_eval.grad_fn is not None,
)
print(
    y_infer.requires_grad,
    y_infer.grad_fn,
)
여기서 비교할 것은 예측 숫자가 아닙니다.
model.training은False,y_eval의 두 검사는True,y_infer쪽은False와None이 되는 구조입니다. Linear의 가중치는 기본적으로 미분 대상이어서, 입력x가 미분 대상이 아니어도y_eval의 연산을 기록할 이유가 있습니다. inference mode 안에서는 그 기록을 만들지 않습니다.출력 두 개가 같은지부터 보면 오히려 차이를 놓칠 수 있습니다. 이 예제에서 Dropout은 두 계산 모두 평가 상태이므로, 기록 여부가 달라도 레이어가 적용하는 계산은 같습니다. 이미 평가 모드인 모델에 inference_mode를 추가하는 목적은 예측 식을 바꾸는 데 있지 않습니다.
inference_mode만 켜면 Dropout은 그대로입니다
nn.Dropout은 학습 상태에서 일부 원소를 확률적으로 0으로 만들고 나머지를 조정합니다. 평가 상태에서는 입력을 그대로 통과시킵니다. 이 분기는 모듈의 학습 상태를 따릅니다. Dropout 동작따라서 다음처럼 모델을 다시 학습 상태로 바꾼 뒤 inference mode에서 실행하면, 미분 기록은 꺼져 있어도 Dropout의 학습 동작은 남습니다.
model.train()
with torch.inference_mode():
    y = model(x)
이 코드를 보고 “기록을 껐으니 모든 학습 관련 동작도 멈췄다”고 해석하면 안 됩니다. BatchNorm이 들어 있는 모델이라면 누적 통계도 살펴야 합니다. 기본 설정의 BatchNorm은 학습 때 통계를 갱신하고 평가 때 저장된 통계를 사용합니다. 다만
track_running_stats=False로 만들었다면 평가 때도 현재 배치 통계를 사용합니다. BatchNorm1d 설정평가 결과가 배치 구성에 따라 달라지는 문제를 보고 있다면 이 옵션이 다음 확인 대상입니다. eval 호출만 계속 추가해도 통계를 저장하지 않도록 만든 레이어의 설정까지 바뀌지는 않습니다. 사용자 정의 모듈 역시
self.training을 어떻게 읽는지에 따라 평가 상태의 효과가 결정됩니다.다음 계산에 미분이 필요하면 no_grad를 검토합니다
inference mode는 미분 그래프 기록 외에도 텐서의 view 추적과 version counter 갱신 부담을 줄입니다. 대신 그 안에서 만든 텐서를 나중에 autograd가 기록하는 계산에 사용하는 데 제약이 있습니다. 출력 텐서가 어디로 가는지를 보고 적용 범위를 정해야 합니다. inference_mode의 제약
가령 고정한 특징 추출기
encoder의 출력으로 작은 분류기head만 학습하려 한다고 하겠습니다. encoder를 평가 상태로 두는 것과 head가 미분에 사용할 특징을 만드는 것은 함께 고려해야 합니다. 이 경우에는 다음과 같은 no-grad 경로를 먼저 검토할 수 있습니다.encoder.eval() with torch.no_grad(): features = encoder(inputs) predictions = head(features) loss = loss_fn( predictions, targets ) loss.backward()encoder 구간을 기록하지 않아도 head의 가중치를 업데이트할 수 있도록, 그 뒤의 연산은 기본 grad 모드에서 수행합니다.
encoder,head, 입력과 손실 함수가 준비됐다는 전제의 구조 예시입니다. encoder까지 함께 학습하려면 이 구간을 no_grad로 감싸는 선택 자체를 다시 봐야 합니다.또 평가 상태의 모델에서 입력 민감도를 구하는 작업이라면 미분이 바로 목적입니다. 그 계산을 inference_mode로 감싸면 원하는 작업을 할 수 없습니다. “추론 코드”라는 파일 이름보다 이번 호출에서 미분이 필요한지가 기준입니다.
블록이 끝나도 모델은 평가 상태로 남습니다
with torch.inference_mode():를 빠져나오면 해당 범위의 grad 모드가 복원됩니다. 그 안팎에서 호출한model.eval()의 효과까지 되돌리지는 않습니다. 같은 모델로 학습을 재개한다면model.train()을 호출할 위치를 명시해야 합니다.또 inference mode는 현재 스레드에 적용됩니다. 다른 스레드가 실행하는 연산까지 자동으로 바뀌지 않습니다. 모델 객체를 여러 요청이 공유한다면 요청마다 train과 eval을 번갈아 바꾸는 방식도 조심해야 합니다. 한 요청의 객체 상태 변경을 다른 요청이 볼 수 있기 때문입니다. 추론 전용 모델은 초기화 때 평가 상태를 정하고, 실제 계산이 실행되는 범위에 grad 모드를 적용하는 식으로 책임을 나누면 확인하기 쉽습니다.
마지막으로 eval이 모델 전체의 재현성을 보장하지는 않습니다. Dropout의 평가 동작과 장치·연산 구현·무작위성에 따른 차이는 각각 확인할 문제입니다. 두 모드를 설정했다는 사실만으로 다른 환경의 출력을 비트 단위로 같다고 판정할 수 없습니다.
현재 추론 함수에서 먼저
model.training과 중요한 하위 모듈의 상태를 확인하세요. 그다음 출력이 화면 표시로 끝나는지, 다음 학습이나 미분 계산으로 이어지는지 따라가면 됩니다. 전자는 eval과 inference_mode의 조합을, 후자는 eval과 no_grad 또는 기본 grad 모드의 조합을 검토할 근거가 됩니다.728x90반응형'AI Agent' 카테고리의 다른 글
ONNX 변환은 성공했는데 입력 크기를 바꾸면 실패하는 이유 (0) 2026.09.28 모델을 INT8로 줄였는데 결과가 달라진 이유 (0) 2026.09.28 AI 캐시 토큰 비용을 일반 입력 토큰과 따로 계산해야 할 때 (0) 2026.09.25 확장자 없는 R2 파일을 AI Search가 읽게 하려면 (0) 2026.09.23 max_new_tokens를 늘리면 긴 문서를 더 많이 읽을까 (0) 2026.09.23